01 / OVERVIEW
把数据搬运
留给专用通道
在图像重建、波形批处理和仿真计算中,大量时间并不花在单次运算,而是耗在反复读写、矩阵变换和等待主机调度。MX2 的规划方向,是把连续的大块数据送入板上内存,在计算阵列中完成批量乘加、变换或归约,再把结果送回主机。
该方式适合计算模式相对稳定、数据规模较大且需要缩短处理时延的仪器系统。它并非替代采集卡,而是可以作为高速采集后端的数据处理单元。
02 / ARCHITECTURE
面向数据流的
计算组织方式
HOST控制与任务队列
→PCIe ×16DMA 数据交换
→MEMORY高带宽工作区
→MATRIX CORE并行计算阵列
主机侧负责算法编排、参数下发与结果管理;板卡侧以 DMA 传输获得连续数据块,并在本地工作区进行流水化执行。对于不同的应用,可通过软件层将卷积、矩阵乘法、FFT 前后处理或图像重建的热点路径映射到计算阵列。
03 / WORKFLOW
从采集到结果
减少一次往返
- 01采集或读取原始数据
上游采集卡、相机或存储系统向主机提供原始数据块。
- 02DMA 下发任务与数据
驱动将数据和计算描述符通过 PCIe 通道送至 MX2。
- 03本地并行计算
板上内存与计算阵列配合,处理成批的矩阵与张量数据。
- 04回传中间或最终结果
主机获得结果,用于显示、存储或后续控制决策。
04 / REFERENCE SPECIFICATION
参考参数
以下为 MX2 的产品定义参考配置,用于系统方案沟通;芯片选型、算力、内存和散热方案可依据项目需求确认。
产品型号YED-PCIe-MX2
主机接口PCIe ×16,Gen 4 兼容
计算架构可编程矩阵运算阵列
参考峰值算力INT8:32 TOPS;FP16:16 TFLOPS
板载内存16GB GDDR6(可选 32GB)
内存带宽最高 448GB/s
主机传输DMA,支持批量数据描述符
外部扩展预留双路高速光口 / 同步接口方向
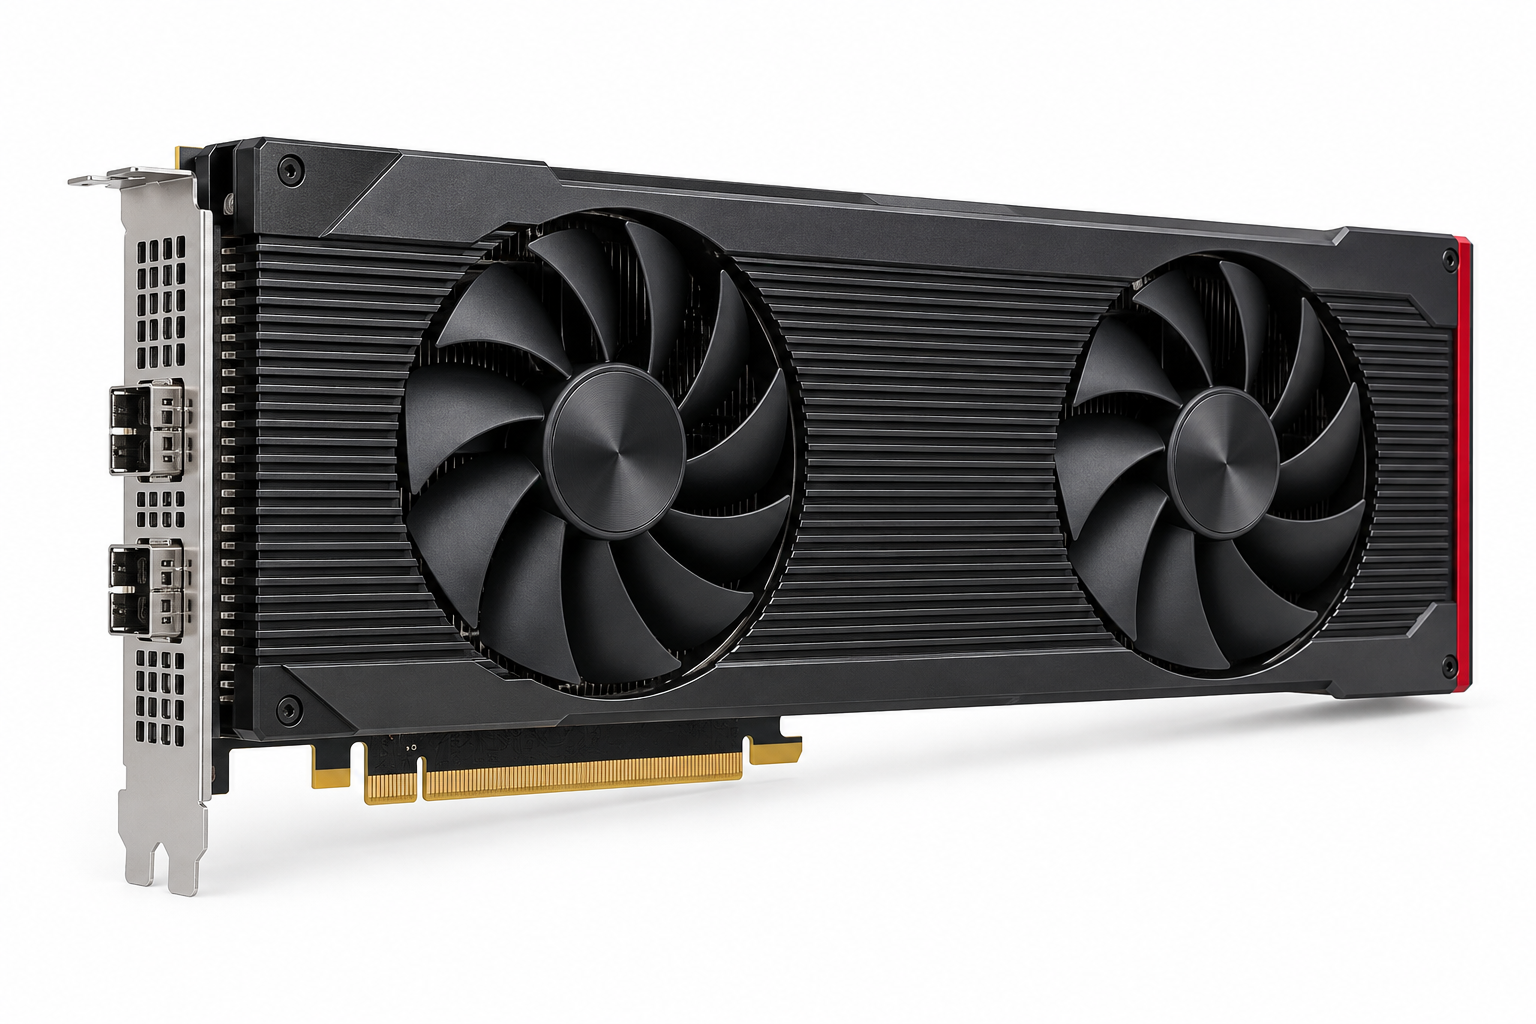
冷却方式双轴流风扇 + 高密度鳍片散热器
供电PCIe 插槽 + 辅助 8pin(参考)
机械尺寸全高全长,双槽宽度(参考)
软件接口C/C++、Python SDK(规划)
05 / DELIVERY NOTES
面向实际系统
定义最终版本
计算密度、数据格式、功耗和 I/O 组合会直接影响板卡的最终配置。项目启动前,建议明确算法精度、单批数据量、实时性目标、主机平台以及环境温度等条件,以便完成计算资源与散热的联合评估。
咨询 MX2 方案